Problem
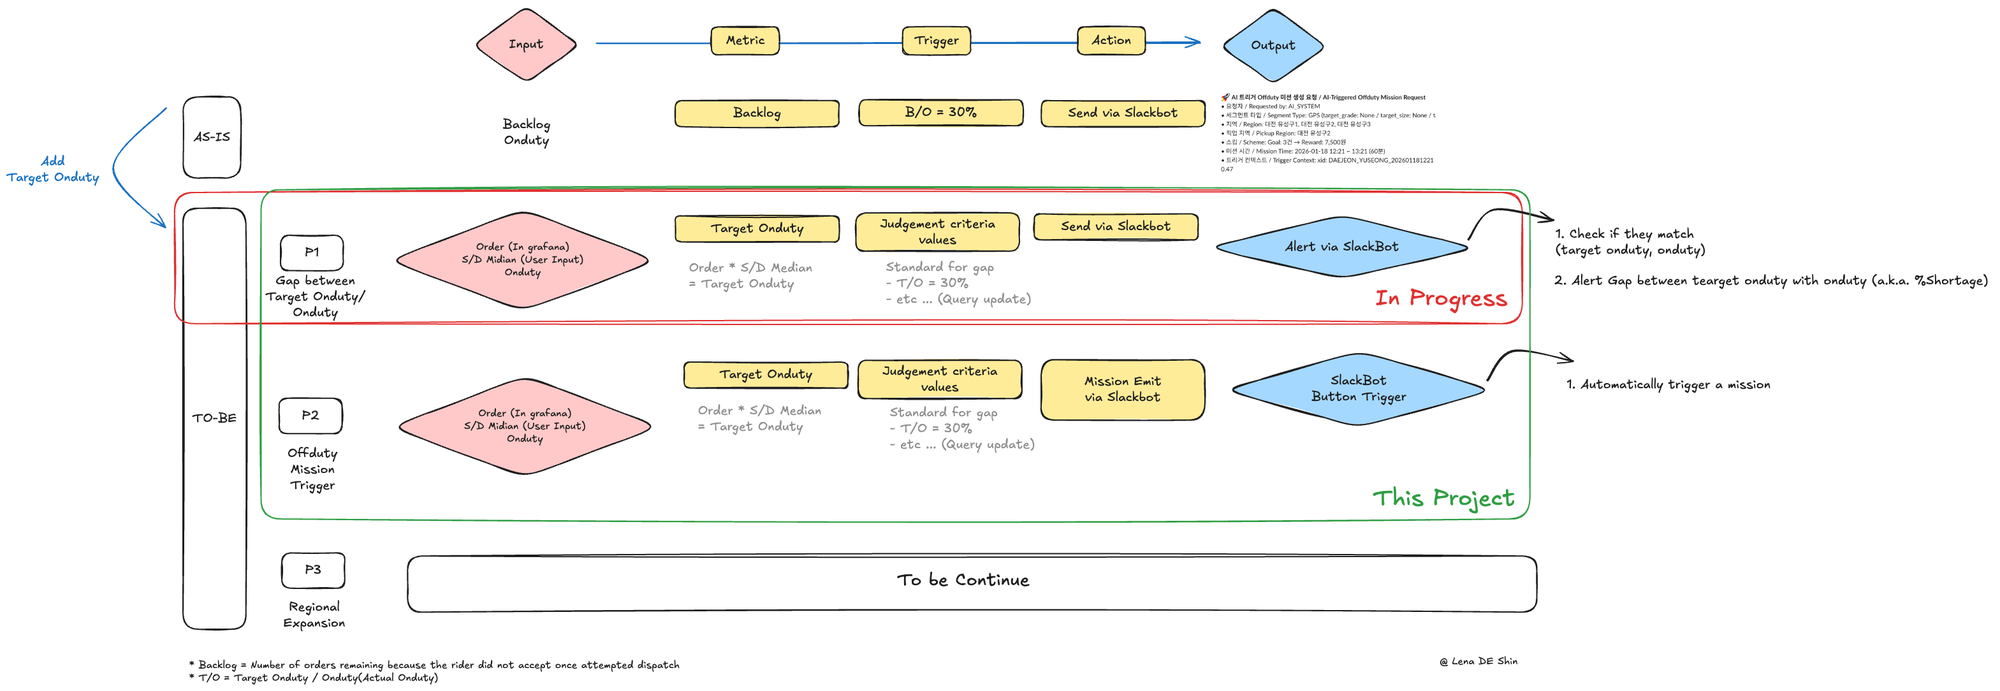
- The existing trigger relied on backlog, a lagging metric, so issues were detected late
- Per-region metric lookups triggered repeated N+1 queries
Company
A leading indicator and alert pipeline that catches operational issues before the lagging backlog does
Period | 2026.01 ~ 2026.02
Detection
Trigger based on backlog, a lagging metric
13 minutes earlier on average (Gangnam backtest)
Per-region reads
100 N+1 queries
1 batched query
Target On Duty as a leading indicator
Backlog only rises after problems pile up, so an earlier signal was defined as the metric
SQLite composite indexes and batched reads
Replaced per-region N+1 queries with a single read